Lagerfehlererkennung – Projekt zur vorausschauenden Wartung und zum maschinellen Lernen
Projekt zur Erkennung von Lagerfehlern mit 100 %iger Genauigkeit mithilfe von CWRU-Schwingungsdaten mit FFT-Signalverarbeitung und maschinellem Lernen mit Zufallsstruktur (Random Forest).

⚙️ PREDICTIVE MAINTENANCE PROJEKT
Erkennung und Klassifizierung von Lagerfehlern
Vorausschauende Wartung mit FFT-Signalverarbeitung und Random Forest Machine Learning
|
%100
Genauigkeit
|
12kHz
Probenahme
|
FFT
Signalanalyse
|
R.F.
Zufälliger Wald
|
1.1 Allgemeiner Zweck des Projekts
Die laufenden Teile (Lager, Getriebe usw.) von Fahrzeugen, die in der Verteidigungsindustrie und in der Schwerindustrie eingesetzt werden, müssen im Hinblick auf ihre Nachhaltigkeit analysiert werden. Verwendung von Sensordaten anstelle herkömmlicher Wartungsmethoden zustandsbasierte vorausschauende Wartung (Predictive Maintenance) ist geplant.
📊 DatenquelleLabordaten der Case Western Reserve University (CWRU). |
🎯 ZielVorerkennung und Klassifizierung des Fehlers |
2.1 Phase der Signalverarbeitung und Frequenzanalyse
Während der Analysephase wurden Daten von der CWRU-Website bezogen 12k Antriebsende Daten verwendet wurden. Zur Analyse und Verarbeitung von Signalen Python welche Programmiersprache verwendet wurde.
Laden von Daten
Hochladen von Daten in das System und Zeichnen zeitabhängiger Diagramme.
Zeitreihenanalyse
Defektes Lager Schläge Es wurde beobachtet, dass.
FFT (Schnelle Fourier-Transformation)
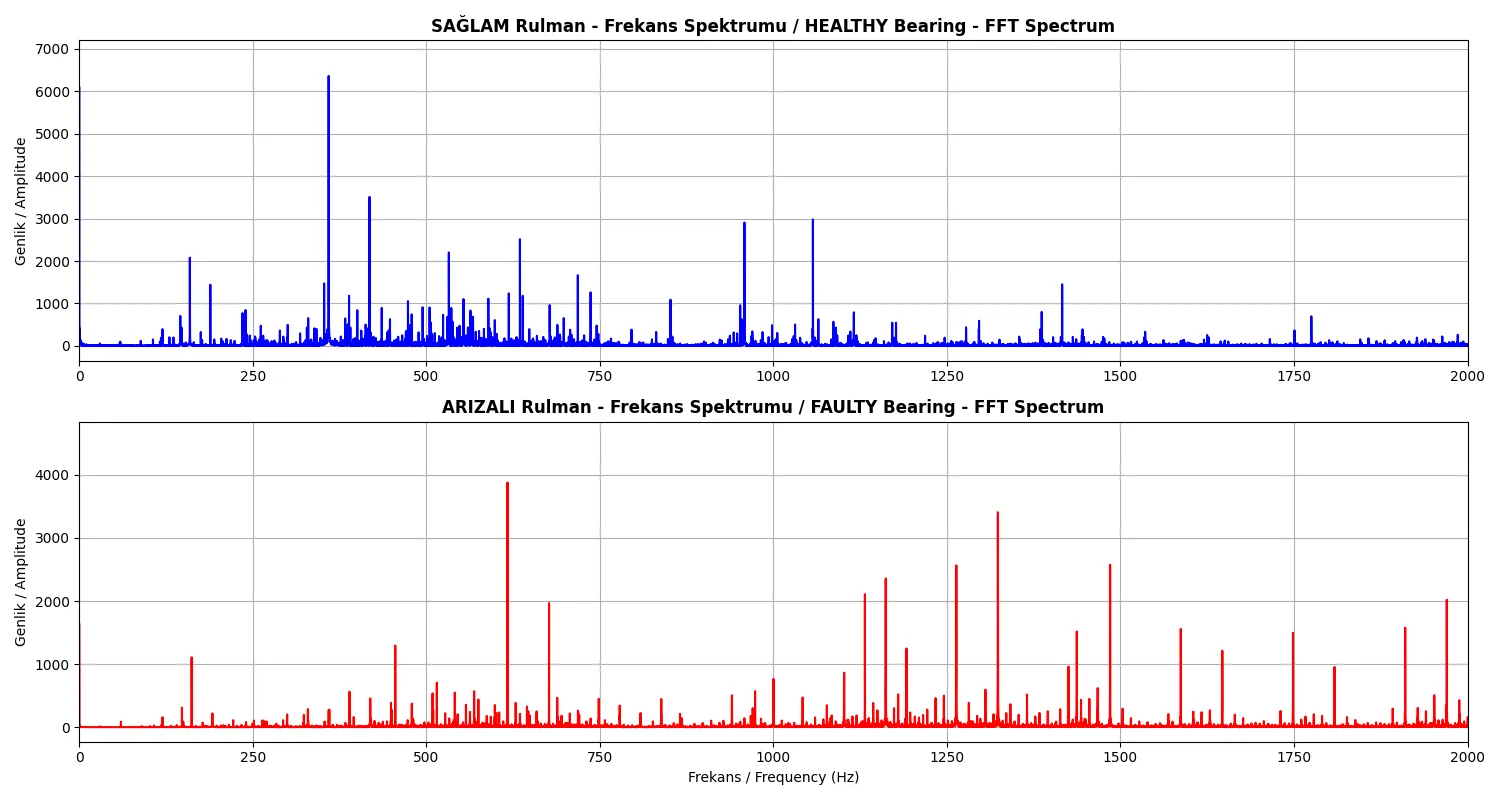
Auf die Signale wurde ein FFT-Verfahren angewendet, um die Frequenz der Impulse zu ermitteln. Bei fehlerhaftem Signal etwa 160 Hz Es wurde ein Energieanstieg festgestellt.
✅ Ergebnis: Es hat sich gezeigt, dass diese Häufigkeiten mit theoretischen Berechnungen übereinstimmen.
💻 Signalverarbeitungscode
# Source - https://stackoverflow.com/q (Modified by Community, CC BY-SA 4.0)

import scipy.io
import matplotlib.pyplot as plt
import numpy as np
from scipy.fft import fft, fftfreq

# Dataları yükleme kısmı
mat = scipy.io.loadmat('arizali.mat')
sinyal = mat['X105_DE_time'].reshape(-1)

# Perform FFT with SciPy
N = len(sinyal)
fs = 12000
yf = fft(sinyal)
xf = fftfreq(N, 1/fs)

# Pozitif frekansları alma
idx_max = N // 2

# Grafik Çizimi
plt.figure(figsize=(10, 6))
plt.plot(xf[:idx_max], np.abs(yf[:idx_max]))
plt.title('Arızalı Rulman Frekans Spektrumu')
plt.grid()
plt.show()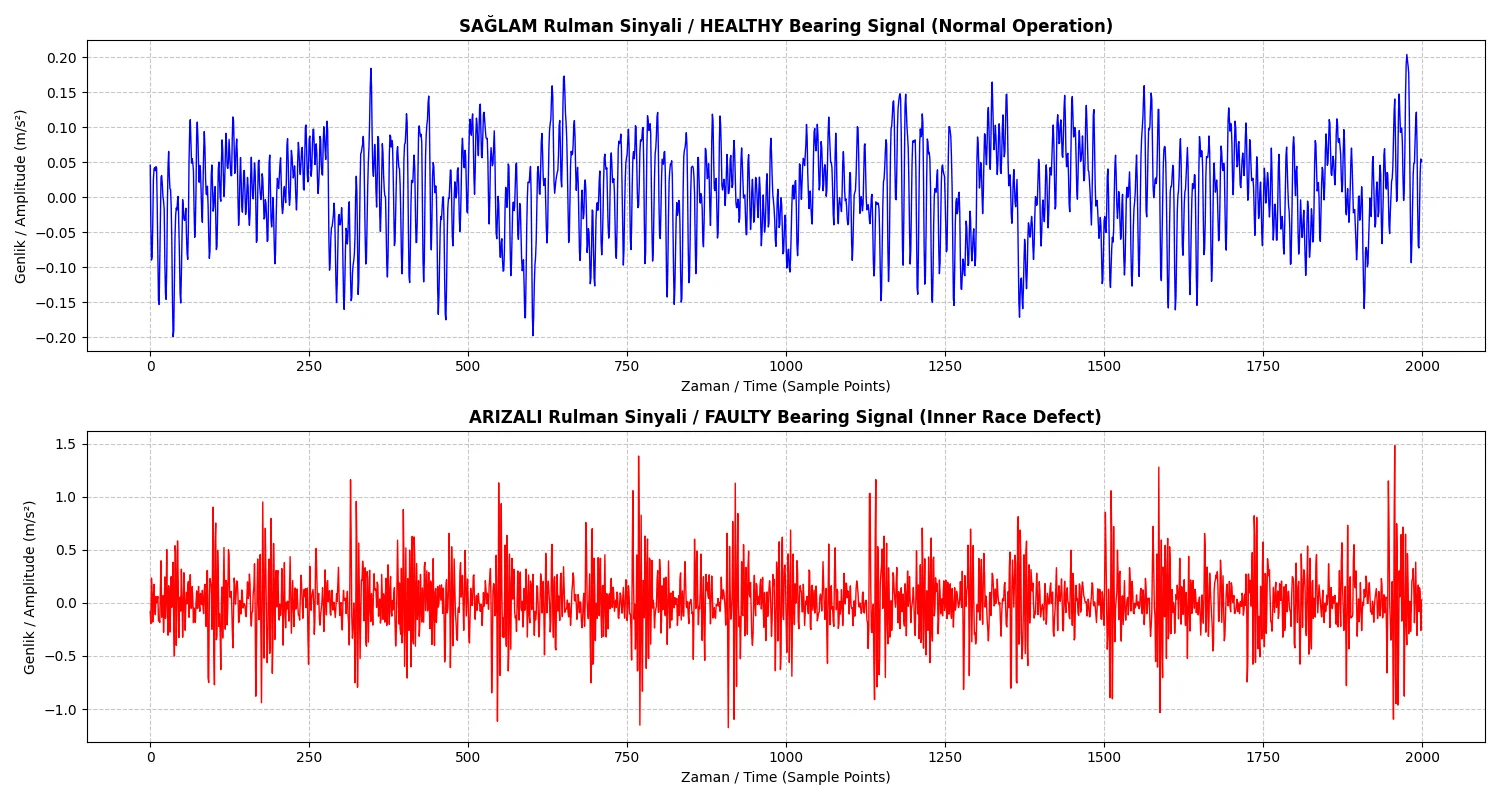
📊Abbildung 1 – Zeitreihenanalyse | Abbildung 2 – Frequenzspektrum
3.1 Merkmalsextraktion und Anwendung künstlicher Intelligenz
Da eine direkte Analyse von Rohsignalen schwierig ist, Merkmalsextraktion Es wurde beschlossen, dies zu tun. Signale in 1000er-Stücke Für jedes Teil wurden folgende Attribute berechnet:
| Attribut | Formel | Beschreibung |
|---|---|---|
| RMS | √(mean(x²)) |
Effektiver Wert des Signals |
| Kurtosis | scipy.stats.kurtosis() |
Das Schärfemaß der Verteilung |
| Maximaler Wert | max(|x|) |
Maximaler absoluter Wert |
📊 Beobachtung: In der Grafik ist zu sehen, dass gesunde und fehlerhafte Daten bei der Berechnung auf Basis von RMS-Werten voneinander getrennt werden.
💻 Funktionsextraktionscode
# Source - StackOverflow (CC BY-SA 4.0)
import pandas as pd
from scipy.stats import kurtosis

def ozellik_cikar(sinyal, etiket):
    ozellikler = []
    parca_boyutu = 1000
    for i in range(0, len(sinyal) - parca_boyutu, parca_boyutu):
        parca = sinyal[i : i + parca_boyutu]

        # RMS ve diğer özellikler hesaplanıyor
        rms = np.sqrt(np.mean(parca**2))
        kurt = kurtosis(parca)
        max_val = np.max(np.abs(parca))

        ozellikler.append([rms, max_val, kurt, etiket])
    return ozellikler

# DataFrame oluşturma
df_features = pd.DataFrame(ozellikler,
    columns=['RMS', 'Max_Value', 'Kurtosis', 'Label'])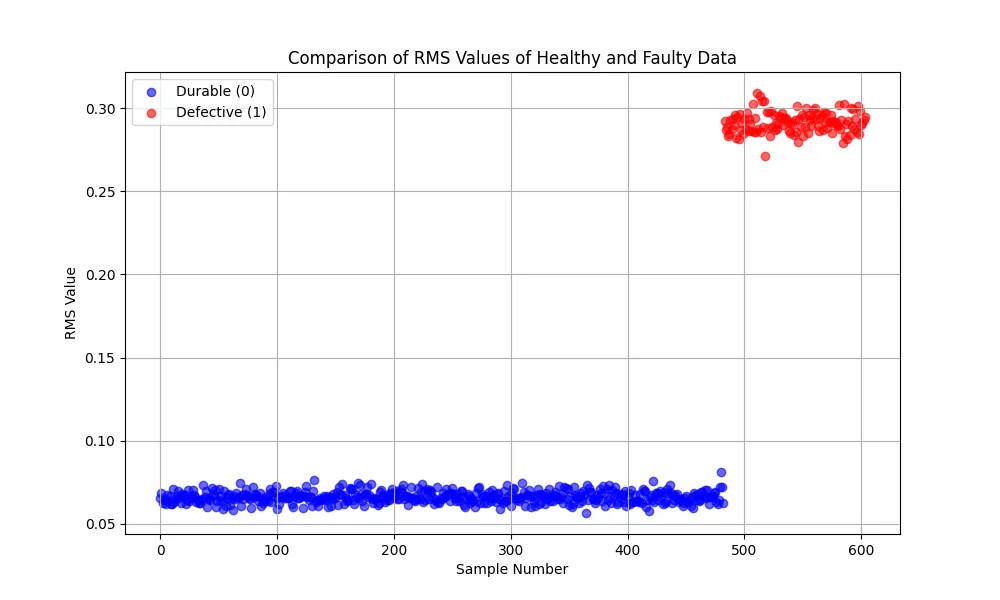
📊Abbildung 3 – Merkmalstrennung (RMS)
4.1 Auswertung der Ergebnisse
Erhaltene Attributdaten Zufälliger Wald Es wurde mit dem Algorithmus trainiert.
|
%100
Genauigkeit
|
80/20
Training/Test-Verhältnis
|
📈 Funktionsbedeutung: Ihr wichtigstes Merkmal Maximaler Wert und RMS Es wurde als Ergebnis der Analyse gesehen.
🔍 Ergebnisse der Verwirrungsmatrix
Modell intakt und defekte Teile ohne Fehler hat sich getrennt.
💻 Modellschulungscode
# Source - StackOverflow (CC BY-SA 4.0)
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split

# Split Data
X = df_features[['RMS', 'Max_Value', 'Kurtosis']]
y = df_features['Label']
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42)

# Model Training
model = RandomForestClassifier(n_estimators=100)
model.fit(X_train, y_train)

# Prediction
y_pred = model.predict(X_test)
acc = accuracy_score(y_test, y_pred)
print(f"Model Accuracy: {acc*100:.2f}")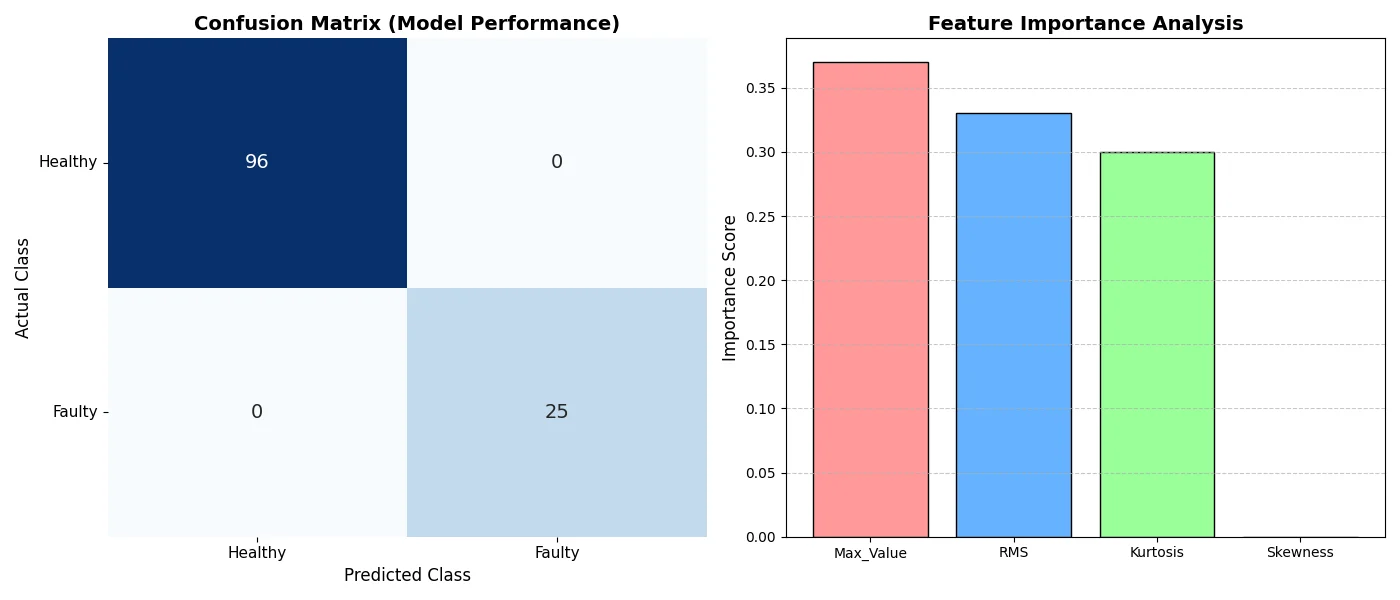
📊Abbildung 4 – Verwirrungsmatrix
🛠️ Verwendete Technologien
|
🐍
Python |
📊
NumPy |
🔬
SciPy |
🤖
scikit-lernen |
📈
matplotlib |
🐼
Pandas |
Ähnliche Projekte
Alle Ansehen ->
SkyTrace - Python-basierte Raketenorbital-Simulation
Die parametrische Raketensimulation wurde mit Newtons Bewegungsgesetzen und aerodynamischen Luftwide...
Projekt ansehen arrow_right_alt
Echtzeit-Panzer- und gepanzerte Fahrzeugerkennung mit Spotter UAV-YOLOv8
YOLOv8-basiertes autonomes Bedrohungserkennungssystem für die Verteidigungsindustrie. Echtzeit-Erke...
Projekt ansehen arrow_right_alt
Design und Herstellung von Kohlefaser-Sandwich-Monocoque-Chassis
Abschlussarbeit mit 12 kg Kohlefaser-Sandwich-Monocoque-Chassis, entwickelt für die TEKNOFEST Effic...
Projekt ansehen arrow_right_alt